一、状态数优化
1. 状态数的自简化
有时候,真正有用的 $dp$ 状态非常少。通过观察状态的实际可达范围,可以主动缩小 $dp$ 数组规模,从而减少求解时间。
---
例题 1:A96798.美丽数组
题意:给定数组 $a$,求所有长度为 $k$ 的子序列 $b$ 的美丽值之和。美丽值定义为:
$$ \min_{1\le ij\le k}\lvert b_i-b_j\rvert $$
思路:
- 将 $b$ 排序后,若相邻差的最小值为 $x$,则有:
- 直接计算“美丽值恰好等于 $x$”较困难,改为计算“美丽值 $\geq x$”的方案数,再做差分更容易。
- 对每个 $i$,满足 $a_i-a_k\ge lim$ 的最大可行 $k$ 随 $i$ 单调变化;
- 用双指针 + 前缀和维护可转移区间,即可把每次转移从 $O(n)$ 降到 $O(1)$。
- 有 $3$ 道题,每题按过题人数决定分值($500,1000,\dots,3000$)。
- 你可以 hack 某些人:每 hack 一次加 $100$ 分。
- 每个人某题得分形如:
- 总分最大 $9000$,因此 hack 次数最多 $90$;
- 能被 hack 的人数量也至多 $90$。
- 先枚举每道题的分值(等价于确定每题可 hack 人数),复杂度 $O(7^3)$;
- 确定后“hack 越多越好”,你的分数可直接计算;
- 再用 $dp_{i,j,k}$ 统计每题 hack 次数固定时,你能达到的最小排名,时间复杂度约为:
- 至少做一道菜
- 每个烹饪方法最多只能做一道菜
- 所有食材至多在一半的菜中出现
- 对每一种可能的 $\left\lceil\frac{j}{b_i}\right\rceil$ 分组;
- 在组内只取能使 $\left\lfloor\frac{a_i}{b_i}\right\rfloor$ 最大的 $b_i$(通常取最大的 $b_i$)。
- $1$ 的位置可以录取人
- $0$ 的位置一定不能录取人
- $w_i$:前 $i$ 个字符中 $0$ 的个数
- $t_i$:前 $i$ 个字符中,有多少个 $1$ 位置最终无法录取
- $v_i$:第 $i$ 个位置能录取所需的最小忍耐度
- 若位置录取:要求 $v_i \le c_x$
- 若位置不录取:要求 $v_i c_x$
- 与 $i$ 同奇偶的最大值一定在 $dp_{i-2}$
- 与 $i$ 异奇偶的最大值一定在 $dp_{i-3}$
- 把难维度(范围大/不好压)变成 dp 值(通常记最小/最大),
- 把好维度(范围小/可二分/只关心最左最右)留在状态里,
- 最终把复杂度从
O(大维度)换成O(小维度)或O(小维度 log …)。 - 原写法: $$ f(\text{情况/状态}) = \text{在这种情况下最优的(最大/最小)值} $$
- 换维写法: $$ g(\text{目标最优值}) = \text{要达到这个值,状态量至少/最多要多少} $$
- 你只保留了“达到某个值的最小资源”这一个最优信息;
- 但你必须证明: 以后做转移时,只需要知道这个“最小资源”就够了,不会因为丢了别的信息导致错过全局最优/合法性。
dp[v] = 达到总价值 v 的最小总重量- 初始化:
dp[0]=0,其他是+inf - 转移(倒序 v):
$$ b_k-b_1 \ge (k-1)x \quad\Rightarrow\quad x \le \frac{b_k-b_1}{k-1} $$
因此美丽值的取值范围相对较小。
固定阈值 $lim$,定义:
$$ dp[i][j] : \text{在前 } i \text{ 个数中,选了 } j \text{ 个,且最后一个选的是 } a_i \text{ 的方案数} $$
转移:
$$ dp[i][j] = \sum_{\substack{ki\\ a_i-a_k\ge lim}} dp[k][j-1] $$
优化:
最终对每个 $lim$:
$$ cnt[lim] = \sum_{i=k}^{n} dp[i][k] $$
再对 $cnt[\cdot]$ 做一次差分即可得到“美丽值恰为 $lim$”的方案数,并累加贡献。
---
例题 2:A96797.Hack,还是不 Hack,这是个问题
题意:
$$ score_i=\frac{x_i(250-t_i)}{250} $$
求最终排名的最小可能值。
思路要点:
$$ O(30^3\cdot 90) $$
总体复杂度:
$$ O(7^3\cdot 30^3\cdot 90) $$
---
例题3:[CSP-J 2025] 多边形
题意:给定 $n$ 个小木棍的长度,求 $3$个及以上的小木棍的合集中,组成多边形的方案数。
思路:$dp_{i,j}:前i个小木棍当中,组成总和为j的方案数$,其中 $j$ 的取值可以很大,但是真正有用的取值只有$0 \sim 5000$,因此任何超过 $5000$ 的总和全部默认为 $5001$ 。
2. 状态合并
在初步设计 $dp$ 时,往往会设计一些“含义清晰但信息冗余”的状态。进一步分析后,若发现其中一些维度并不会影响后续决策,就可以合并这些状态,从而减少状态数。
---
例题:([CSP-S 2019] Emiya 家今天的饭)
题意:
给定一个二维矩阵a,定义 $a_{i,j}$ 代表了用第 $i$ 种烹饪方法和第 $j$ 种食材做的菜的种数,现有三条规定:
求做菜的方案数
思路:
首先约束所有的食材的出现次数非常的麻烦,于是考虑正难则反,有且仅有一种主要食材的出现次数会超过一半,考虑求解这一类的方案数即可。
顺着这点继续往下思考,我们可以依次枚举每一种主要食材(列),然后依次求出它们超过一半的方案数。接着我们需要知道当前这一列做了几道菜以及总共做了几道菜,于是就有了状态定义:$f_{i,j,k}$ 代表了前 $i$ 行当中,选择了 $j$ 道菜 , 其中有 $k$ 道菜是当前食材做的方案数。
令$s_i=\sum_{j=1}^m a_{i,j}$,于是总方案数即为:
$$ \text{tot}=\prod_{i=1}^n (s_i+1)-1 $$
容易想到 DP 求不合法的方案数。我们枚举被选择的数量超过了总数量一半的那一列 \(c\),然后令 \(f_{i,j,k}\) 表示考虑前 \(i\) 行,总共选择了 \(j\) 个位置,第 \(c\) 列选择了 \(k\) 个位置的方案数。转移时考虑当前行不选、选第 \(c\) 列之外的位置或选择第 \(c\) 列的位置,即可得到转移方程:
$$ f_{i,j,k} = f_{i-1,j,k} + f_{i-1,j-1,k}\cdot (s_i-a_{i,c}) + f_{i-1,j-1,k-1}\cdot a_{i,c} $$
转移时注意 \(j\) 和 \(k\) 从 \(0\) 开始枚举。最终答案就是
$$ \text{ans} = \text{tot} - \sum_{j=1}^n \sum_{k=\left\lfloor \frac{j}{2}\right\rfloor +1}^{j} f_{n,j,k} $$
这么做的时间复杂度是$O(mn^3)$的,还不足以通过本题,于是需要考虑使用优化。
我们会发现:$f_{i,j,k}$ 的后两维都是在描述相似的东西“选了几个”,而我们在乎的仅仅只是第 $c$ 列有没有超过其他列的总数,至于其他列到底选了多少个我们并不在乎。因此我们考虑将两者合并成同一个意义,也就是第 $c$ 列和其他列“相差了几个”。
我们可以将状态变为 $f_{i,j}$,表示前 $i$ 行,当前列的数比其他列的数多了 $j$ 个,则有转移:
$$ f_{i,j} = f_{i-1,j} + a_{i,c}\cdot f_{i-1,j-1} + (s_i-a_{i,c})\cdot f_{i-1,j+1} $$
转移仍然是 $O(1)$ 的,但总复杂度降为 $O(mn^2)$,可以通过此题。
---
3. 下标换元(状态重定义)
本节属于状态设计优化:通过状态重定义触发上文的“自简化”或“状态合并”,从而减少状态数。
---
3.1 状态换元
有时只需转换状态定义,就能把状态数显著压缩。
##### 例题:A96793.Welcome24ever 和巧克力
题意:
给定数组 $a$ 和正整数 $k$,构造数组 $b$,满足:
$$ k \le \prod_{i=1}^{n} b_i $$
最大化:
$$ k\cdot \frac{\prod_{i=1}^{n}\left\lfloor\frac{a_i}{b_i}\right\rfloor}{\prod_{i=1}^{n} a_i}, \qquad n=100,\ a_i\le 10^7 $$
思路:
朴素状态:
$$ f_{i,j}=\text{前 } i \text{ 个数,使 } \prod_{x=1}^{i} b_x=j \text{ 的最优值} $$
但 $j$ 的范围是巨大的,显然不可行。
换元:
$$ f_{i,j}=\text{考虑前 } i \text{ 个数后,剩余需求为 } j \text{ 的最优值} $$
其中
$$ j=\left\lceil\frac{k}{\prod_{x=1}^{i} b_x}\right\rceil \quad\Longleftrightarrow\quad \prod_{x=i+1}^{n} b_x\ge j $$
转移:
$$ f_{i,\left\lceil\frac{j}{b_i}\right\rceil} \leftarrow f_{i-1,j}\times \left\lfloor\frac{a_i}{b_i}\right\rfloor\times \frac{1}{a_i} $$
处理取整:
$$ \left\lceil\frac{j}{b_i}\right\rceil = \left\lfloor\frac{j-1}{b_i}\right\rfloor+1 $$
并利用性质:
$$ \left\lceil \frac{\left\lceil \frac{j}{x} \right\rceil}{y} \right\rceil = \left\lceil \frac{j}{xy}\right\rceil = \left\lfloor \frac{j-1}{xy} \right\rfloor + 1 $$
因此对任意转移,第二维始终形如:
$$ \left\lfloor\frac{k-1}{x}\right\rfloor+1 $$
而 $\left\lfloor\frac{k-1}{x}\right\rfloor$ 的不同取值个数可用整除分块证明为 $O(\sqrt{k})$,从而触发状态数自简化:
$$ \text{状态数 } = O(n\sqrt{k}) $$
接下来优化转移:不能枚举所有 $b_i$。
对固定状态 $f_{i-1,j}$,观察到 $\left\lceil\frac{j}{b_i}\right\rceil$ 的不同取值也很少(整除分块,约 $O(\sqrt{j})$)。因此:
于是单次转移复杂度变为:
$$ O(\sqrt{j}) $$
总体复杂度可写为:
$$ O\!\left( n\times \sum_{t=1}^{\sqrt{k}} \left(\sqrt{t}+\sqrt{\frac{k}{t}}\right) \right) = O(n\cdot k^{0.75}) $$
---
3.2 转成补集(容斥)
若题目中出现两个限制条件方向相反($\le$ 与 $$ 同时出现),往往难以直接计数。可以对其中一个方向取补集,配合容斥把问题变成“同向限制”。
##### 例题:([CSP-S 2025] 员工招聘)
题意:
给定长度为 $n$ 的 $01$ 串:
共有 $n$ 个人,第 $x$ 个人忍耐度为 $c_x$。为所有人分配应聘顺序:若某人在应聘时,前方录取失败人数超过 $c_x$,则他一定不会被录取。
求所有方案中,录取人数超过 $m$ 的方案数。
思路:
预处理:只考虑 $1$ 位置
$0$ 位置对“能否录取”不产生可控贡献(必失败),可用“特殊元素优先处理”:
1. 先把所有 $1$ 位置安排并计数;
2. 剩下的位置再乘上排列数补回。
下文“位置”均指 $1$ 的位置。
定义:
则:
$$ v_i=t_i+w_i $$
---
Step 1:先看 $m=1$
当“录取人数超过 $1$”,可先算“全都录取不了”的方案数 $res$,再做:
$$ ans = |\Omega| - res,\qquad |\Omega|=n! $$
令计数函数:
$$ S(p)=\left|\{x\mid c_x\le p\}\right| $$
若记第 $r$ 个 $1$ 的原下标为 $pos_r$,则“全不录取”的乘法计数可写成类似:
$$ res=\prod_{r=1}^{k}\left(S(pos_r-1)-(r-1)\right) $$
其中 $k$ 为 $1$ 的总数。
---
Step 2:出现反向限制,用容斥统一方向
枚举某个状态 $s$(二进制表示哪些 $1$ 位置录取):
两类条件方向相反,直接计数困难。定义事件 $A_i$:位置 $i$ “无法录取”。则需求为:
$$ \left|\bigcap_{i\in s}\overline{A_i}\right| $$
利用补集与容斥:
$$ \left|\bigcap_{i\in s}\overline A_i\right| = |\Omega|-\left|\bigcup_{i\in s}A_i\right| $$
注意空集合 $T=\varnothing$ 时:
$$ \bigcap_{i\in \varnothing} A_i = \Omega $$
并写成标准容斥形式(含空集):
$$ \left|\bigcap_{i\in s}\overline{A_i}\right| = \sum_{T\subseteq s}(-1)^{|T|} \left|\bigcap_{i\in T}A_i\right| $$
做法:对每个状态 $s$,枚举其子集 $T$,计算 $\left|\bigcap_{i\in T}A_i\right|$ 并按 $(-1)^{|T|}$ 加减。
---
Step 3:把重复的子集枚举用 DP 计算
在 Step 2 中,很多量会被重复计算,因此用 DP 代替“对每个 $s$ 枚举所有 $T$”。
示例状态:
$$ dp_{i,j,k}: \text{前 } i \text{ 个 } 1 \text{ 中,} j \text{ 个钦定不录取,} k \text{ 个因容斥而不录取} $$
把容斥求和结构嵌入 $dp$ 递推即可。
---
4. 最优性去状态
在最优化 DP 中,常可利用支配关系 / 单调性 / 等价路径删掉“不可能成为最优解”的状态,或只保留“代表状态”,从而降低复杂度。
---
例题:打家劫舍
设共有 $n$ 个房屋,第 $i$ 个房屋价值为 $a_i$,相邻房屋不能同时打劫。
状态定义:
$$ dp_i:\ \text{在前 } i \text{ 个房屋中,且打劫了第 } i \text{ 个房屋时的最大价值} $$
转移:
$$ dp_i=\max_{x\le i-2}(dp_x)+a_i $$
关键性质:
$$ dp_i \ge dp_{i-2}+a_i \ge dp_{i-2} $$
因此:
从而:
$$ \max_{x\le i-2}(dp_x)=\max\big(dp_{i-2},dp_{i-3}\big) $$
优化后转移:
$$ dp_i=\max\big(dp_{i-2},dp_{i-3}\big)+a_i $$
只需维护少量历史状态即可。
---
例题 2:[NOIP2023] 天天爱打卡
题意:
一共有 $n$ 天,大 Y 可以花费 $d$ 的能量在任何一天跑步,但大 Y 不能在连续的 $k$ 天跑步。
此外,将给出 $m$ 段任务区间 $[l_i,r_i]$。如果在这段区间的每一天都跑了步,则会获得 $v_i$ 的能量。
大 Y 的初始能量为 $0$,请你最大化跑完步后大 Y 最终的能量。
思路:
有一个最朴素的状态设计方案就是 $f_i$ 表示考虑前 $i$ 天并且第 $i$ 天跑步的最大能量值 ,然后定义 $g_i = \max\limits_{j=1}^{i}f_{j}$
转移方程:
$$ f_i = \max_{j=i-k + 1}^{\,i} \left\{ g_{j-2} -(i-j + 1)\cdot d + \sum_{[l_p,r_p]\subseteq [j,i]} v_p \right\} $$
这样子直接暴力转移的时间复杂度是$O(nmk)$的。
可以想到,对于枚举的区间 $[j,i]$,能够贡献答案的任务区间 $[l_k,r_k]$ 一定满足$j\le l_k\le r_k\le i$。
现在我们将区间 $[l_i,r_i]$ 看作是二位平面上的点 $(r_i,l_i)$ , 那么我们就能把后面的暴力求和变成求解二维平面上矩形的点权和,于是乎变成了一个基础的二维数点问题。
那么我们按照右端点顺序把任务区间加入,则 $r_k\le i$ 的条件就能天然满足。计算贡献时,我们就只需要查询满足 $l_k\ge j$ 的任务区间的权值和即可,这个可以用树状数组维护,单次计算贡献的复杂度降至 $O(\log m)$,整体时间复杂度$O(nklog_{m})$
接下来考虑优化 $n$ ,由于最终的得分和完成的任务以及跑步的时间有关,因此会发现在一个区间开始或结束的时间开始跑步是一定不劣的,在一个区间的结束的时间完成跑步也一定不劣。因此我们的决策点就只有每个任务的 $l_i , r_i$ 两个点,这样就可以大大的减少状态数量,时间复杂度也就成了 $O(mklog_m)$ ,这就是通过最优性质来保留一定不劣的点,减少状态数。
最后,还剩下一个瓶颈没有解决:对于每一个端点都要枚举前 $k$ 个。所以我们需要接着优化 $dp$ 转移
转移为
$$ dp_i = \max_{\substack{1\le j\le i\\ p_i-p_j+1\le k}} \left\{ g_{\mathrm{pre}(j)} +\text{gain}(i,j) -\text{cost}(i,j) \right\}. $$
另外,由于相邻关键天数之间可能存在空档天,需要区分“$p_{j-1}$ 与 $p_j$ 是否相邻”:
$$ \mathrm{pre}(j)= \begin{cases} j-2, & j\ge 2\ \text{且}\ p_j=p_{j-1}+1,\\ j-1, & \text{否则}. \end{cases} $$
最后有
$$ g_i=\max(g_{i-1},dp_i). $$
接下来我们考虑从 $i \to i+1$的过程中,每个决策点的 $g_{pre(j)}$ 不变,$cost(i,j)$ 变化量一样,$gain(i,j)$ 的变化量取决于 $j$ 的大小,也就是说实际上这是一个区间修改+区间查询的问题,很自然想到用线段树来维护每个决策点 $g_{pre(j)} + gain(i,j) - cost(i,j)$ 的取值,然后在进行区间查询最值即可,查询范围可以双指针快速解决。时间复杂度为$O(mlog_m)$
---
5. 最优性换维
把原来 DP 里“状态的一维”挪到“dp 记的值”里(或者反过来),从而:
具体而言:
你可以把 DP 看成一个函数:
例如:
f[w] = 重量不超过 w 时最大价值例如:
g[v] = 达到总价值 v 所需的最小重量但是,也不能无脑的进行换维:
因为你换维之后,经常会出现这种直觉陷阱:
通常证明套路是:
对任意最优解,取“最后一步/最后一个物品/最后一段”,前面部分必然也是对应子问题的最优(否则就能替换得更好,矛盾)。
例题1:A94852.Knapsack 2
题意:
n 个物品,每个有重量 w[i]、价值 val[i],背包容量 W,最大化总价值。##### 常规 DP(容量当维度)
dp[cap] = 最大价值复杂度
O(nW),但如果 W 很大(比如 1e9)就炸了。##### 换维 DP(价值当维度)
令
S = sum(val)(如果价值和不大,比如 1e5),定义:dp[v + val[i]] = min(dp[v + val[i]], dp[v] + w[i])最后答案是最大的
v,使得 dp[v] <= W。这就是“定义域值域互换”:从“容量 -> 最大价值”换成“价值 -> 最小容量”。
例题2:LIS 最长上升子序列(“二分性/最左1”压维)
题意:给数组
a,求 LIS 长度。##### 常规 DP($O(n^2)$)
f[i] = 以 i 结尾的 LIS 最长长度##### 换维/压维写法($O(n log\ n)$)
定义:
dp[len] = 长度为 len 的上升子序列,其“最小可能结尾值”性质:
dp[len] 随 len 单调递增(或至少可二分定位)。对每个
a[i],找最大的 len 使得 dp[len] < a[i],更新 dp[len+1]=min(dp[len+1], a[i])。这里就是:
---
二、转移优化
在优化前先说明两种 $dp$ 转移类型
针对不同的转移类型,会有不同的转移优化,例如在填表法中常见的优化有前缀和,在刷表法中常见的优化有维护差分数组,刷表法常在计数类型动态规划中出现。
1.前后缀优化
此处不过多赘述,主要就是维护前缀/后缀的最值/总值/第k大,进而实现快速转移。
2.多步拆单步
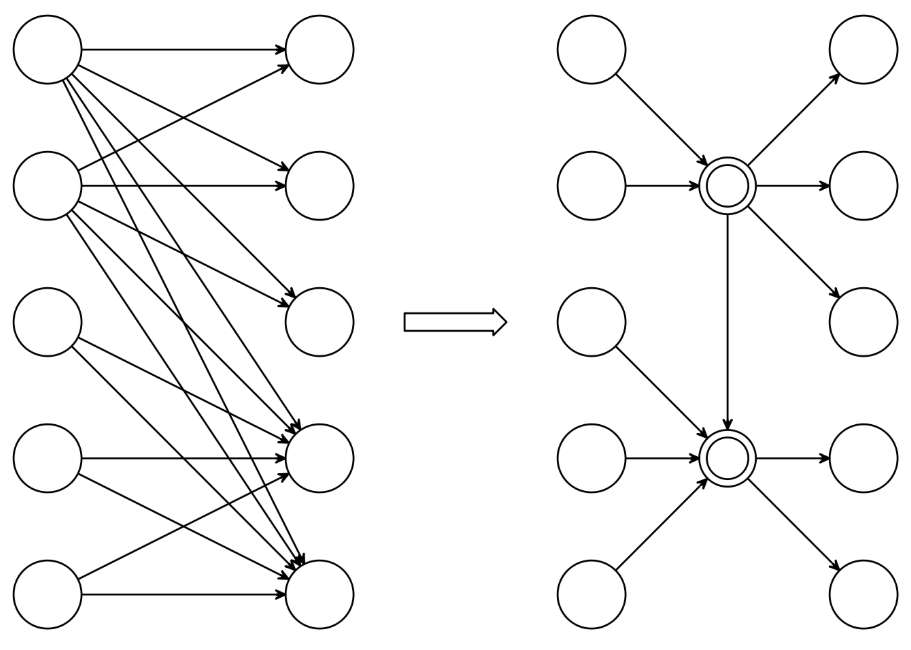
类似于图论当中的“建虚点”,在此处可以通过建立另外的数组来记录值,然后进而快速转移,上文的前后缀优化也可以看作是多步拆单步。
3.倍增
倍增适用于转移轮数很大($n = 10^9$) ,并且转移方程和转移轮数无关的情况,经典问题有各种矩阵乘法,完全背包。
例题:「NOI2020」美食家
4. ds 优化 dp 转移
根据转移方程选取合适的ds实现转移,例如上文[NOIP2023] 天天爱打卡:$f_i = \max\limits_{j i}f_j + g(i,j)$ ,需要实现区间修改和区间最值,那么用线段树来实现快速转移会很合适。
5. 决策单调性优化
01
函数求和
普及/提高-
--
练习
02
放糖果
普及/提高-
--
练习
03
混合实验
普及/提高-
--
练习
04
跳格子
普及/提高-
--
练习
05
Welcome24ever 和便当
普及/提高-
--
练习
06
「NOIP2024」遗失的赋值
普及+/提高
--
练习
07
琪露诺
普及+/提高
--
练习
08
fangz 补习班
普及+/提高
--
练习
09
前向走
普及+/提高
--
练习
10
Knapsack 2
普及/提高-
--
练习
11
导弹拦截
普及+/提高
--
练习
12
奶牛比赛
普及+/提高
--
练习
13
[CSP-J 2025] 多边形 / polygon
普及/提高-
--
练习
14
树的完美染色
普及+/提高
--
练习
15
「NOI2020」美食家
省选/NOI-
--
练习
16
Welcome24ever 和喷灌器
提高+/省选-
--
练习
17
Welcome24ever 和 MEX
提高+/省选-
--
练习
18
「CSP-S 2023」消消乐
提高+/省选-
--
练习
19
美丽数组
省选/NOI-
--
练习
20
Hack,还是不 Hack,这是个问题
NOI/NOI+/CTSC
--
练习
21
「NOIP2023」天天爱打卡
省选/NOI-
--
练习
22
颜色配对
普及+/提高
--
练习
23
Welcome24ever 和象棋
提高+/省选-
--
练习
24
01串分数最值
提高+/省选-
--
练习
25
Welcome24ever 和巧克力
省选/NOI-
--
练习
26
[CSP-S 2025] 员工招聘
省选/NOI-
--
练习
27
「CSP-S 2019」Emiya 家今天的饭
提高+/省选-
--
练习
28
小组项目分组
省选/NOI-
--
练习