1.
有6个元素,按照 6,5,4,3,2,1 的顺序进入栈S,下列( )的出栈序列是不能出现的( )。
有6个元素,按照 6,5,4,3,2,1 的顺序进入栈S,下列( )的出栈序列是不能出现的( )。
关于Python中面向对象的类的继承,下面说法错误的是( )
对上题中的二叉搜素树,当输入数组为 [ 5 , 3 , 7 , 2 , 4 , 6 , 8 ] [5,3,7,2,4,6,8][5,3,7,2,4,6,8] 时,构建二叉搜索树,并采用如下代码实现的遍历方式,得到的输出是( )。
def traversal(tree_node* root) :
	if (root == nullptr) {
		return
	}

traversal(root->left)
print(root->val)
print(" ")
traversal(root->right)阅读以下用动态规划解决的0-1背包问题的函数,假设背包的容量 W WW 是10kg,假设输入4个物品的重量 w e i g h t s weightsweights 分别为 1,3,4,6(单位为kg),每个物品对应的价值 v a l u e s valuesvalues 分别为 20,30,50,60,则函数的输出为( )。
def knapsack(capacity, weights, values):
	dp = [[0 for _ in range(capacity + 1)] for _ in range(len(weights) + 1)]
	for i in range(1, len(weights) + 1):
		for j in range(1, capacity + 1):
			if weights[i - 1] <= j:
				dp[i][j] = max(dp[i - 1][j], dp[i - 1][j - weights[i - 1]] + values[i - 1])
			else:
				dp[i][j] = dp[i - 1][j]
	return dp[-1][-1]

weights = [1, 3, 4,6]
values = [20,30,50,60]
capacity = 10
print(knapsack(capacity, weights, values))
动态规划通常用于解决( )。
给定一棵二叉树,其前序遍历结果为:ABDECFG,中序遍历结果为:DEBACFG,则这棵树的正确后序遍历结果是( )。
以下基于二叉树的搜索实现的深度计算函数中横线上应填写( )。
class Node:
	def __init__(self, data):
		self.data = data
		self.left = None
		self.right = None

def height(root):
	if root is None:
		return 0
	else:
		left_height = height(root.left)
		right_height = height(root.right)
		_________________________________
假设字母表 {a,b,c,d,e} 在字符串出现的频率分别为 10%,15%,30%,16%,29%。若使用哈夫曼编码方式对字母进行二进制编码,则字符 abcdef 分别对应的一组哈夫曼编码的长度分别为( )。
二叉搜索树中的每个结点,其左子树的所有结点值都小于该结点值,右子树的所有结点值都大于该结点值。以下代码对给定的整数数组(假设数组中没有数值相等的元素),构造一个对应的二叉搜索树,横线上应填写():
class TreeNode:
	def __init__(self, x):
		self.val = x
		self.left = None
		self.right = None

class Solution:
	def isValidBST(self, root: TreeNode) -> bool:
		def helper(node, min_val, max_val):
			if not node:
				return True
			————————————————————————————————————————————————
				return False
			return helper(node.left, min_val, node.val) and helper(node.right,node.val, max_val)

return helper(root, float('-inf'), float('inf'))采用如下代码实现检查输入的字符串括号是否匹配,横线上应填入的代码为( )。
class Stack:
	def __init__(self):
		self.items = []
	def is_empty(self):
		return not self.items
	def push(self, item):
		self.items.append(item)
	def pop(self):
		if not self.is_empty():
			return self.items.pop()
	def peek(self):
		if not self.is_empty():
			return self.items[-1]
	def size(self):
		return len(self.items)

def paren_match(expr):
	s = Stack()
	balanced = True
	index = 0
	while index < len(expr) and balanced:
		symbol = expr[index]
		if symbol in '([{':
			________________
		else:
			if s.is_empty():
				balanced = False
			else:
				top = s.pop()
			if not matches(top, symbol):
				balanced = False
		index += 1

	if balanced and s.is_empty():
		return True
	else:
		return False

def matches(opening, closing):
	opens = '([{'
	closers = ')]}'
return opening in opens and closers.index(closing) == opens.index(opening)以下( )没有涉及Python语言的面向对象特性支持。
以下Python代码实现 n 位的格雷码,则横线上应填写( )。
def generate_gray_code(n):
	if n <= 0:
		return []
	if n == 1:
		return [0, 1]

	gray_code = generate_gray_code(n - 1)
	————————————————————————————————————————
	for x in gray_code]
	return gray_code + inverted_gray_code
二叉树的深度定义为从根结点到叶结点的最长路径上的结点数,则以下基于二叉树的深度优先搜索实现的深度计算函数中横线上应填写( )。
class Node:
	def __init__(self, data):
		self.data = data
		self.left = None
		self.right = None

def max_depth(root_node):
	if root_node is None:
		return 0
	else:
		left_depth = max_depth(root_node.left)
		right_depth = max_depth(root_node.right)
		_______________________________________
一棵有 n 个结点的完全二叉树用数组进行存储与表示,已知根结点存储在数组的第 1 个位置。若存储在数组第 9 个位置的结点存在兄弟结点和两个子结点,则它的兄弟结点和右子结点的位置分别是( )。
下面代码判断队列的第一个元素是否等于 a,并删除该元素,横向上应填写( )。
import queue
q = queue.Queue()
a = 'a'
if ________________________________________
	q.get()
	print('元素 {} 是队列的第一个元素,并已被移除。'.format(a))
else:
print('队列的第一个元素不是 {}.'.format(a))在python中,类的静态成员变量只能被该类对象的成员函数访问。
应用动态规划算法时,识别并存储重叠子问题的解是必须的。
状态转移方程是动态规划的核心,可以通过递推方式表示问题状态的变化。
如果根结点的深度记为 1,则一棵恰有 2024 个叶结点的二叉树的深度最少是 12。
哈夫曼编码本质上是一种贪心策略。
运行以下python代码,屏幕将输出“derived class”。
class BaseClass:
	def my_method(self):
		print("base class")

class DerivedClass(BaseClass):
	def my_method(self):
		print("derived class")

derived_instance = DerivedClass()
derived_instance.my_method()如下列代码所示的基类(base)及其派生类(derived),则生成一个派生类的对象时,只调用派生类的构造函数。
class Base:
	def __init__(self):
		print("Base.__init__ called")

class Derived(Base):
	def __init__(self):
		print("Derived.__init__ called")
		super().__init__()
d = Derived()栈和队列均可通过数组或链表来实现,其中数组实现支持随机访问、占用内存较少,但插入和删除元素效率低;链表实现的元素插入与删除效率高,但元素访问效率低、占用内存较多。
C++、Python和JAVA等都是面向对象的编程语言。
在非递归实现的树的广度优先搜索中,通常使用栈来辅助实现。
算法学习
时间限制:1.0 s
内存限制:512.0 MB
题面描述
小杨计划学习m种算法,为此他找了n道题目来帮助自己学习,每道题目至多学习一次。
小杨对于m种算法的初始掌握程度均为 0。第i道题目有对应的知识点ai即学习第i道题目可以令小杨对第ai种算法的掌握程度提高bi。小杨的学习目标是对m种算法的掌握程度均至少为k 。
小杨认为连续学习两道相同知识点的题目是不好的,小杨想请你编写程序帮他计算出他最少需要学习多少道题目才能使得他在完成学习目标的同时避免连续学习两道相同知识点的题目。
输入格式
第一行三个正整数m,n,k,代表算法种类数,题目数和目标掌握程度。
第二行n个正整数a1,a2,a3,...,an,代表每道题目的知识点。
第二行n个正整数b1,b2,b3,...,bn,代表每道题目提升的掌握程度。
输出格式
输出一个整数,代表小杨最少需要学习题目的数量,如果不存在满足条件的方案,输出 -1。
输入样例1
3 5 10
1 1 2 3 3
9 1 10 10 1
输出样例1
4
输入样例2
2 4 10
1 1 1 2
1 2 7 10
输出样例2
-1
对于样例1,一种最优学习顺序为第一道题,第三道题,第四道题,第二道题。
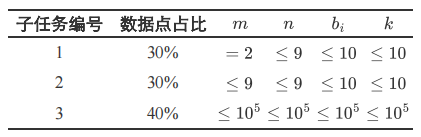
对于全部数据,保证有1≤m,n≤105,1≤bi,k≤105,1≤ai≤m。
小杨和整数拆分
时间限制:20.0 s
内存限制:512.0 MB
题面描述
小杨有一个正整数n,小杨想将它拆分成若干完全平方数的和,同时小杨希望拆分的数量越少越好。
小杨请你编写程序计算出总和为n的完全平方数的最少数量。
输入格式
第一行包含一个正整数n,含义如题面所示。
输出格式
输出一个整数,代表总和为 n nn 的完全平方数的最少数量。
输入样例
18
输出样例
2
18=9+9=16+1+1,其中最少需要2个完全平方数。
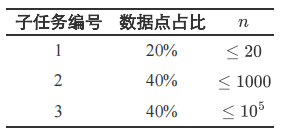
对于全部数据,保证有1≤n≤105。
可保存默认模板;新题优先使用已保存模板。
当前快捷键仅展示,暂不支持修改。
Ctrl / ⌘ + ZCtrl / ⌘ + YCtrl / ⌘ + FCtrl / ⌘ + ACtrl / ⌘ + CCtrl / ⌘ + XCtrl / ⌘ + V工具栏排版按钮编辑时自动保存到本机历史
提交记录AI
作答助手确定要清空代码吗?
确定退出考试模式吗?当前作答进度会暂存在本机会话中,下次可继续。
正在处理答卷,请稍候…