2025年11月 LMCC大模型认证 成人组 第一轮真题
剩余时间 --:--:--
单选题 共 30 题
1.

以下哪⼀项是精确率( Precision)的计算公式? 注:TP(True Positive ,真阳性)、 FP(False Positive ,假阳性)、TN(True Negative ,真阴性)、 FN( False Negative ,假阴性);
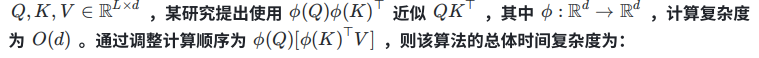
2.
在预训练技术中,下⼀个词元预测任务(Next Token Prediction)主要基于以下哪种核⼼思想?
3.
关于⾃注意⼒机制,以下哪项描述是正确的?
4.
关于⼤语⾔模型的优势与局限性,以下描述正确的是?
5.
关于⼤语⾔模型的训练流程,以下哪项分阶段描述最准确?
6.
除了⽆害性、有⽤性和诚实性,⼈类对⻬还可能包含哪些重要标准?
7.
下列哪个项是⼤语⾔模型产⽣偏⻅的主要来源?
8.
按照语⾔模型的发展历程,以下四代模型的正确时间顺序是:
9.
关于贪⼼搜索(Greedy Search)和束搜索(Beam Search)这两种解码策略,以下描述正确的是:
10.
关于过拟合(Overfitting)现象,以下描述正确的是?
11.
直接偏好优化(Direct Preference Optimization, DPO)的核⼼思想是什么?
12.
关于前缀微调(Prefix Tuning)与提⽰微调(Prompt Tuning)的异同点,以下哪种说法最准确?
13.
关于AdamW优化器的改进,以下说法正确的是?
14.
在深度学习模型训练过程中,梯度裁剪(Gradient Clipping)技术的主要作⽤是什么?
15.
关于知识利⽤能⼒评测中时效性要求的理解,以下哪项描述最准确?
16.
在评估⼤语⾔模型的逐步推理能⼒时,以下哪种情况最能体现模型的真实推理⽔平?
17.

已知标准注意⼒的计算复杂度为 ,其中序列⻓度为 O(L2d),特征维度为 L。设

18.
在深度学习模型训练中,混合精度训练(Mixed Precision Training)技术的主要作⽤是什么?
19.
在提⽰学习中,以下哪项不属于⼈⼯提⽰设计的基本原则?
20.
某预训练任务初始批次⼤⼩(Batch Size)为256,采⽤梯度累积(Gradient Accumulation)策 略每4步更新⼀次,实际等效批次⼤⼩是多少?若改为动态调整策略,在训练中期将批次⼤⼩增⾄ 512,请计算梯度累积步数应如何调整以保持等效批次⼤⼩不变?
21.
Qwen2.5 模型需要加载⽀持⾃定义代码的分词器。请选择正确的加载⽅式:
22.
为优化推理效率,需要⾃动分配 GPU 设备并使⽤半精度格式以节省显存。请选择正确的模型加载 ⽅式:
23.
推理前需要将模型移⾄⽬标设备并切换到评估模式以禁⽤ Dropout 等训练⾏为。请选择正确的实现⽅式:
24.
需要对 logits 应⽤温度缩放并通过 softmax 转换为概率分布以控制⽣成多样性。请选择正确的实 现⽅式:
25.
⽣成完成后需要将新增的 token 序列解码为可读⽂本。请选择正确的解码⽅式:
26.
需要将 q_nope 通过头依赖的权重矩阵 k_nope_w 投影到 KV 低秩空间。请选择正确的张量运算⽅式:
27.
投影后的查询向量需要与 kv_cache 做相关性计算以获得注意⼒分数。请选择正确的实现⽅式:
28.
需要合并两部分注意⼒分数并应⽤ softmax_scale 进⾏缩放。请选择正确的实现⽅式:
29.
为实现因果注意⼒,需要将掩码中不可⻅位置的分数设置为负⽆穷。请选择正确的实现⽅式:
30.
最后需要使⽤ v_w 将聚合后的向量 x 从 KV 空间映射回值空间。请选择正确的实现⽅式: