1.
关于 Python 实现的单链表、双链表和循环链表,下列说法正确的是( )。
关于 Python 实现的单链表、双链表和循环链表,下列说法正确的是( )。
双向循环链表中要在结点 p 之前插入新结点 s (均非空),以下操作正确的是( )。
下面函数删除单向链表中 val == x 的节点,并且使用哑结点统一对头结点和中间节点的删除操作。横线 处应填( )。
1 class Node:
2  def __init__(self, val):
3   self.val = val
4   self.next = None
5
6 def eraseAll(head, x):
7  dummy = Node(0)
8  dummy.next = head
9  cur = dummy
10
11  while cur.next:
12   if cur.next.val == x:
13    ____________________ # 填空处
14   else:
15    cur = cur.next
16  return dummy.next
对如下代码实现的欧几里得算法(辗转相除法),调用 gcd(48, 18) 得到的调用序列为( )。
1 def gcd(a, b):
2  if b == 0:
3   return a
4  else:
5   return gcd(b, a % b)
下面代码实现了欧拉(线性)筛,横线处应填写( )。
1 def euler_sieve_for(n):
2  if n < 2:
3   return []
4  is_composite = [False] * (n + 1)
5  primes = []
6
7  for i in range(2, n + 1):
8   if not is_composite[i]:
9    primes.append(i)
10
11   ___________________________
12    p = primes[j]
13    if i * p > n:
14     break
15    is_composite[i * p] = True
16    if i % p == 0:
17     break
18  return primes
19
埃氏筛中将内层循环从 j = i*i 开始而不是 j = 2*i 的主要原因是( )。
1 def eratosthenes_sieve_for(n):
2  if n < 2:
3   return []
4  is_composite = [False] * (n + 1)
5  primes = []
6
7  for i in range(2, n + 1):
8   if is_composite[i]:
9    continue
10   primes.append(i)
11
12   # 用for循环模拟C++的 j = i*i; j <=n; j +=i
13   for j in range(i * i, n + 1, i):
14    is_composite[j] = True
15
16  return primes
下面程序的运行结果为( )。
1 def check(n, a, k, dist):
2  cnt = 1
3  last = a[0]
4
5  for i in range(1, n):
6   if a[i] - last >= dist:
7    cnt += 1
8    last = a[i]
9
10  return cnt >= k
11
12 def solve(n, a, k):
13  a.sort()
14
15  l = 0
16  r = a[-1] - a[0]
17
18  while l < r:
19   mid = (l + r + 1) // 2
20   if check(n, a, k, mid):
21    l = mid
22   else:
23    r = mid - 1
24
25  return l
26
27 if __name__ == "__main__":
28  a = [1, 2, 8, 4, 9]
29  n = 5
30  k = 3
31  result = solve(n, a, k)
32  print(result)
在升序数组中查找第一个大于等于 x 的位置,下面循环中横线应填( )。
1 def lowerBound(a, x):
2  l = 0
3  r = len(a)
4  while l < r:
5   mid = l + (r - l) // 2
6   if a[mid] >= x:
7    __________________
8   else:
9    l = mid + 1
10  return l
11
12 if __name__ == "__main__":
13  a1 = [1, 3, 5, 7, 9]
14  x1 = 5
15 print(f"数组{a1}中第一个≥{x1}的位置:{lowerBound(a1, x1)}")关于递归函数调用,下列说法错误的是( )。
给定 n 根木头,第 i 根长度为 a[i] 。要切成不少于 m 段等长木段,求最大可能长度,则横线上应填 写( )。
1 def check(a, m, x):
2  cnt = 0
3  for length in a:
4   if x == 0:
5    return True
6   cnt += length
7   if cnt >= m:
8    return True
9  return cnt >= m
10
11 def main():
12  import sys
13  input = sys.stdin.read().split()
14  idx = 0
15  n = int(input[idx])
16  idx += 1
17  m = int(input[idx])
18  idx += 1
19
20  a = []
21  mx = 0
22  for _ in range(n):
23   num = int(input[idx])
24   idx += 1
25   a.append(num)
26   mx = max(mx, num)
27
28  l = 1
29  r = mx
30  ans = 0
31
32  while l <= r:
33   mid = l + (r - l) // 2
34    if check(a, m, mid):
35     ans = mid
36     _______________
37    else:
38     _______________
39
40  print(ans)
41
42 if __name__ == "__main__":
43  main()
下面代码用分治求“最大连续子段和”,其时间复杂度为( )。
1 import sys
2
3 def solve(a, l, r):
4  if l == r:
5   return a[l]
6
7  mid = l + (r - l) // 2
8
9  left = solve(a, l, mid)
10  right = solve(a, mid + 1, r)
11
12  sum_val = 0
13  lmax = -sys.maxsize - 1
14  for i in range(mid, l - 1, -1):
15   sum_val += a[i]
16   lmax = max(lmax, sum_val)
17
18  sum_val = 0
19  rmax = -sys.maxsize - 1
20  for i in range(mid + 1, r + 1):
21   sum_val += a[i]
22   rmax = max(rmax, sum_val)
23
24  return max(left, right, lmax + rmax)
25
26 if __name__ == "__main__":
27  a1 = [-2, 1, -3, 4, -1, 2, 1, -5, 4]
28  print(solve(a1, 0, len(a1)-1))
29
30  a2 = [-5, -3, -1, -4]
31  print(solve(a2, 0, len(a2)-1))
32
33  a3 = [10]
34  print(solve(a3, 0, 0))
游戏大赛决赛,两组选手分别按得分从小到大排好队,现在要把他们合并成一个有序排行榜。A组: A = {12, 35, 67, 89} ,B组: B = {20, 45, 55, 78} ,下面是归并合并函数的核心循环,横线处应填入( )。
1 A = [12, 35, 67, 89]
2 B = [20, 45, 55, 78]
3
4 i = 0
5 j = 0
6 result = []
7
8 while i < len(A) and j < len(B):
9  ————————————————————————
10   result.append(A[i])
11   i += 1
12  else:
13   result.append(B[j])
14   j += 1
15
16 while i < len(A):
17  result.append(A[i])
18  i += 1
19
20 while j < len(B):
21  result.append(B[j])
22  j += 1
23
24
25 print("合并后的有序排行榜:", result)有n位同学的成绩已经从小到大排好序,现在对它执行下面这段以第一个元素为 pivot 的快速排序,请问此次排序的时间复杂度是( )。
1 def quicksort(a, l, r):
2  if l >= r:
3   return
4  pivot = a[l]
5  i, j = l, r
6
7  while i < j:
8   while i < j and a[j] >= pivot:
9    j -= 1
10   while i < j and a[i] <= pivot:
11    i += 1
12   if i < j:
13    a[i], a[j] = a[j], a[i]
14
15  a[l], a[i] = a[i], a[l]
16
17  quicksort(a, l, i - 1)
18  quicksort(a, i + 1, r)
19
20 if __name__ == "__main__":
21  scores = [60, 70, 80, 90, 100]
22  print("排序前:", scores)
23  quicksort(scores, 0, len(scores)-1)
24  print("排序后:", scores) # 输出:[60, 70, 80, 90, 100]
25  def quicksort_with_log(a, l, r, depth=0):
26   if l >= r:
27    return
28   print(f"递归深度{depth},处理区间[{l},{r}],数组:{a[l:r+1]}")
29   pivot = a[l]
30   i, j = l, r
31   while i < j:
32    while i < j and a[j] >= pivot: j -= 1
33    while i < j and a[i] <= pivot: i += 1
34    if i < j: a[i], a[j] = a[j], a[i]
35   a[l], a[i] = a[i], a[l]
36   quicksort_with_log(a, l, i-1, depth+1)
37   quicksort_with_log(a, i+1, r, depth+1)
38
39  scores2 = [60,70,80,90,100]
40  print("\n递归过程:")
41 quicksort_with_log(scores2, 0, 4)下面关于排序算法的描述中,不正确的是( )。
下面代码实现两个整数除法,其中被除数为一个“大整数”,用字符串表示,除数是一个小整数,用 int 表示,则横线处应该填写( )。
1 def big_integer_division():
2  s, b = input().split()
3  b = int(b)
4
5  a = [int(c) for c in s]
6
7  c = []
8  rem = 0
9
10  for i in range(len(a)):
11   rem = rem * 10 + a[i]
12   q = rem // b
13   c.append(q)
14   ______________
15
16  pos = 0
17  while pos < len(c) - 1 and c[pos] == 0:
18   pos += 1
19
20  for i in range(pos, len(c)):
21   print(c[i], end='')
22  print()
23
24  print(rem)
25
26 if __name__ == "__main__":
27  big_integer_division()
有一个存储了 n 个整数的线性表,分别用 Python 列表(数组)和自定义单链表两种方式实现。在已知元素下标(或结点对象引用)的前提下,Python 列表的随机访问操作时间复杂度为O(1);而在 Python 实现的单链表中,已知某结点对象的引用时,在该结点之后插入一个新结点的操作时间复杂度也为O(1)。
若数组 a 已按升序排列,则下面代码可以正确实现 “在 a 中查找第一个大于等于 x 的元素的位置”。
1 def lowerBound(a, x):
2  l = 0
3  r = len(a)
4  while l < r:
5   mid = (l + r) // 2
6   if a[mid] >= x:
7    r = mid
8   else:
9    l = mid + 1
10  return l
11
12 if __name__ == "__main__":
13  a1 = [1, 3, 5, 7, 9]
14  x1 = 5
15  print(f"数组{a1}中第一个≥{x1}的位置:{lowerBound(a1, x1)}")
16
17  x2 = 6
18  print(f"数组{a1}中第一个≥{x2}的位置:{lowerBound(a1, x2)}")
19
20  x3 = 10
21  print(f"数组{a1}中第一个≥{x3}的位置:{lowerBound(a1, x3)}")
22
23  x4 = 0
24 print(f"数组{a1}中第一个≥{x4}的位置:{lowerBound(a1, x4)}")快速排序只要每次都选取中间元素作为枢轴,就一定是稳定排序。
若某算法满足递推式:
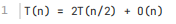
则其时间复杂度为O(nlogn)。
在一个数组中,如果两个元素 a[i] 和 a[j] 满足 i < j 且 a[i] > a[j] ,则 a[i] 和 a[j] 是一个逆 序对。 下面代码可以正确统计数组 a 区间 [l,r] 内的逆序对总数。
1 cnt = 0
2
3 def merge_count(a, l, m, r):
4
5  global cnt
6  i = l
7  j = m + 1
8
9  while i <= m and j <= r:
10   if a[i] <= a[j]:
11    i += 1
12   else:
13    cnt += (m - i + 1)
14    j += 1
15
16 if __name__ == "__main__":
17  a = [2, 4, 1, 3]
18  merge_count(a, 0, 1, 3)
19 print(f"跨区间逆序对数量:{cnt}")唯一分解定理保证:若一个数未被任何不超过其平方根的质数筛去,则它一定是质数。
假设数组 的值域范围是 ,以下程序的时间复杂度是O(nlogn+nlogD)。
1 def check(n, a, k, dist):
2  cnt = 1
3  last = a[0]
4
5  for i in range(1, n):
6   if a[i] - last >= dist:
7    cnt += 1
8    last = a[i]
9
10  return cnt >= k
11
12 def solve(n, a, k):
13  a_sorted = a.copy()
14  a_sorted.sort()
15
16  l = 0
17  r = a_sorted[-1] - a_sorted[0]
18
19  while l < r:
20   mid = (l + r + 1) // 2
21   if check(n, a_sorted, k, mid):
22    l = mid
23  else:
24    r = mid - 1
25
26  return l
27
28 if __name__ == "__main__":
29  a = [1, 2, 8, 4, 9]
30  n = 5
31  k = 3
32  result = solve(n, a, k)
33  print(result)
若一个问题满足最优子结构性质,则一定可以用贪心算法得到最优解。( )
线性筛相比埃氏筛的核心改进在于:埃氏筛中一个合数可能被多个质数重复标记,线性筛通过"每个合数只被其最大质因子筛去"的策略,保证每个合数恰好被标记一次,从而实现O(n)的时间复杂度。
任何递归程序都可以改写为等价的非递归程序,但改写后的非递归程序一定需要显式地使用栈来模拟递归 调用过程。
试题名称:有限不循环小数
时间限制:1.0 s
内存限制:512.0 MB
3.1.1 题目描述
若 可化为一个有限的,不循环的小数,则称a为终止数。
请你求出在L到R中终止数的数量。
3.1.2 输入格式
输入一行,包含两个整数L,R。
3.1.3 输出格式
输出一行,包含一个整数,表示L到R中终止数的数量。
3.1.4 样例
3.1.4.1 输入样例

3.1.4.2 输出样例

3.1.5 样例解释
在[2,11]终止数有2、4、5、8、10。
3.1.6 数据范围
保证1≤L≤R≤106。
试题名称:找数
时间限制:1.0 s
内存限制:512.0 MB
3.2.1 题目描述
给定一个包含n个互不相同的正整数的数组A与一个包含m个互不相同的正整数的数组B ,请你帮忙计算有多少数在数组A与数组B中均出现。
3.2.2 输入格式
第一行包含两个整数n,m。
第二行包含n个正整数a1,a2…,an表示数组A。
第二行包含m个正整数b1,b2,…bm表示数组B。
3.2.3 输出格式
输出一个整数,表示在数组A与数组B中均出现的数的个数。
3.2.4 样例
3.2.4.1 输入样例
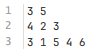
3.2.4.2 输出样例

3.2.5 样例解释
样例1中,4、3在数组A与B中均出现。
3.2.6 数据范围
对于40%的数据,保证1≤n,m≤1000。
对于100%的数据,保证1≤n,m≤105,1≤ai,bi≤109。
可保存默认模板;新题优先使用已保存模板。
当前快捷键仅展示,暂不支持修改。
Ctrl / ⌘ + ZCtrl / ⌘ + YCtrl / ⌘ + FCtrl / ⌘ + ACtrl / ⌘ + CCtrl / ⌘ + XCtrl / ⌘ + V工具栏排版按钮编辑时自动保存到本机历史
提交记录AI
作答助手确定要清空代码吗?
确定退出考试模式吗?当前作答进度会暂存在本机会话中,下次可继续。
正在处理答卷,请稍候…