1.
链表不具备的特点是( )。
链表不具备的特点是( )。
双向链表中每个结点有两个指针域prev和next,分别指向该结点的前驱及后继结点。设p指向链表中的一个结点,它的前驱结点和后继结点均非空。要删除结点p,则下述语句中错误的是( )。
假设双向循环链表包含头尾哨兵结点(不存储实际内容),分别为head和tail,链表中每个结点有两个指针域prev和next,分别指向该结点的前驱及后继结点。下面代码实现了一个空的双向循环链表,横线上应填的最佳代码是( )。
1 // 链表结点
2 template <typename T>
3 struct ListNode {
4  T data;
5  ListNode* prev;
6  ListNode* next;
7
8  // 构造函数
9  explicit ListNode(const T& val = T())
10   : data(val), prev(nullptr), next(nullptr) {}
11 };
12
13 struct LinkedList {
14  ListNode<T>* head;
15  ListNode<T>* tail;
16 };
17
18 void InitLinkedList(LinkedList* list) {
19  list->head = new ListNode<T>;
20  list->tail = new ListNode<T>;
21  ________________________________ // 在此处填入代码
22 };用以下辗转相除法(欧几里得算法)求gcd(84, 60)的步骤中,第二步计算的数是( )。
1 int gcd(int a, int b) {
2  int big = a > b ? a : b;
3  int small = a < b ? a : b;
4  if (big % small == 0) {
5   return small;
6  }
7  return gcd(small, big % small);
8 }根据唯一分解定理,下面整数的唯一分解是正确的( )。
下述代码实现素数表的线性筛法,筛选出所有小于等于n的素数,横线上应填的最佳代码是( )。
1 vector<int> sieve_linear(int n) {
2  vector<bool> is_prime(n +1, true);
3  vector<int> primes;
4
5  if (n < 2) return primes;
6
7  is_prime[0] = is_prime[1] = false;
8  for (int i = 2; i <= n/2; i++) {
9   if (is_prime[i])
10    primes.push_back(i);
11
12   for (int j = 0; ________________________________ ; j++) { // 在此处填入代码
13    is_prime[ i * primes[j] ] = false;
14    if (i % primes[j] == 0)
15     break;
16   }
17  }
18
19  for (int i = n/2 +1; i <= n; i++) {
20   if (is_prime[i])
21    primes.push_back(i);
22  }
23
24  return primes;
25 }在程序运行过程中,如果递归调用的层数过多,会因为( )引发错误。
对下面两个函数,说法错误的是( )。
1 int factorialA(int n) {
2  if (n <= 1) return 1;
3  return n * factorialA(n-1);
4 }
5 int factorialB(int n) {
6  if (n <= 1) return 1;
7  int res = 1;
8  for(int i=2; i<=n; i++)
9   res *= n;
10 }下算法中,( )是不稳定的排序。
考虑以下C++代码实现的快速排序算法,将数据从小到大排序,则横线上应填的最佳代码是( )。
1 int partition(vector<int>& arr, int low, int high) {
2  int pivot = arr[high]; // 基准值
3  int i = low - 1;
4
5  for (int j = low; j < high; j++) {
6   ________________________________ // 在此处填入代码
7  }
8  swap(arr[i + 1], arr[high]);
9  return i + 1;
10 }
11
12 // 快速排序
13 void quickSort(vector<int>& arr, int low, int high) {
14  if (low < high) {
15   int pi = partition(arr, low, high);
16   quickSort(arr, low, pi - 1);
17   quickSort(arr, pi + 1, high);
18  }
19 }若用二分法在[1,100]内猜数,最多需要猜( )次。
下面代码实现了二分查找算法,在数组arr找到目标元素target的位置,则横线上能填写的最佳代码 是( )。
1 int binarySearch(int arr[], int left, int right, int target) {
2  while (left <= right) {
3   ________________________________ // 在此处填入代码
4
5   if (arr[mid] == target)
6    return mid;
7   else if (arr[mid] < target)
8    left = mid + 1;
9   else
10   right = mid - 1;
11  }
12  return -1;
13 }单链表中删除某个结点p(非尾结点),但不知道头结点,可行的操作是将p的值设为p->next的值,然后删除p->next。
链表存储线性表时要求内存中可用存储单元地址是连续的。
线性筛相对于埃拉托斯特尼筛法,每个合数只会被它的最小质因数筛去一次,因此效率更高。
贪心算法通过每一步选择当前最优解,从而一定能获得全局最优解。
递归函数必须具有一个终止条件,以防止无限递归。
快速排序算法的时间复杂度与输入是否有序无关,始终稳定为O(nlogn)。
归并排序算法的时间复杂度与输入是否有序无关,始终稳定为O(nlogn)。
二分查找适用于对无序数组和有序数组的查找。
小杨有100元去超市买东西,每个商品有各自的价格,每种商品只能买1个,小杨的目标是买到最多数量的商品。小杨采用的策略是每次挑价格最低的商品买,这体现了分治思想。
归并排序算法体现了分治算法,每次将大的待排序数组分成大小大致相等的两个小数组,然后分别对两个小数组进行排序,最后对排好序的两个小数组合并成有序数组。
3.1 编程题 1
时间限制:1.0 s
内存限制:512.0 MB
3.1.1 平均分配
3.1.2 题目描述
小A有2n件物品,小B和小C想从小A手上买走这些物品。对于第i件物品,小B会以bi的价格购买,而小C会以ci的价格购买。为了平均分配这2n件物品,小A决定小B和小C各自只能买走恰好n件物品。你能帮小A求出他卖出这2n件物品所能获得的最大收入吗?
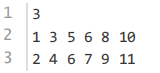
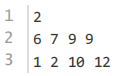
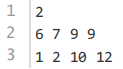
3.1.3 输入格式
第一行,一个正整数n。
第二行,2n个整数b1,b2,…,b2n。
第三行,2n个整数c1,c2,…,c2n。
3.1.4 输出格式
一行,一个整数,表示答案。
3.1.5 样例
3.1.5.1 输入样例 1
3.1.5.2 输出样例 1

3.1.5.3 输入样例 2
3.1.5.4 输出样例 2

3.1.6 数据范围
对于20%的测试点,保证1≤n≤8。
对于另外20%的测试点,保证0≤bi≤1,0≤ci≤1。
对于所有测试点,保证1≤n≤105,0≤bi≤109,0≤ci≤109。
3.2 编程题 2
时间限制:1.0 s
内存限制:512.0 MB
3.2.8 原根判断
3.2.9 题目描述
小A知道,对于质数p而言,p的原根g是满足以下条件的正整数:
1<g<p;
gp-1mod p=1;
对于任意1≤i≤p-1均有gimodp≠1。
其中a mod p表示a除以p的余数。
小A现在有一个整数a,请你帮他判断a是不是p的原根。
3.2.10 输入格式
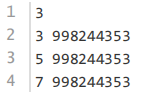
第一行,一个正整数T,表示测试数据组数。
每组测试数据包含一行,两个正整数a,p。
3.2.11 输出格式
对于每组测试数据,输出一行,如果a是p的原根则输出Yes,否则输出No。
3.2.12 样例
3.2.12.5 输入样例 1
3.2.12.6 输出样例 1

3.2.13 数据范围
对于40%的测试点,保证3≤p≤103。
对于所有测试点,保证1≤T≤20,3≤p≤109,1<a<p,p为质数。
可保存默认模板;新题优先使用已保存模板。
当前快捷键仅展示,暂不支持修改。
Ctrl / ⌘ + ZCtrl / ⌘ + YCtrl / ⌘ + FCtrl / ⌘ + ACtrl / ⌘ + CCtrl / ⌘ + XCtrl / ⌘ + V工具栏排版按钮编辑时自动保存到本机历史
提交记录AI
作答助手确定要清空代码吗?
确定退出考试模式吗?当前作答进度会暂存在本机会话中,下次可继续。
正在处理答卷,请稍候…