1.
假设一个算法时间复杂度的递推式是T(n)=2T(n-1)+1(n为正整数),且T(o)=1 ,那么这个算法的时间复杂度是( )。
假设一个算法时间复杂度的递推式是T(n)=2T(n-1)+1(n为正整数),且T(o)=1 ,那么这个算法的时间复杂度是( )。
下面关于“唯一分解定理”和“素数筛法”的说法中,错误的是( )。
若字符串A与字符串B的最长公共子序列(LCS)长度为 5,则( )。
对于一棵包含n个顶点(n≥2 )的树,其所有顶点的度数之和必定等于( )。
关于哈希表(Hash Table)在不考虑扩容且采用简单均匀哈希函数的前提下,下列说法中错误的是( )。
在 Kruskal 算法中,会将边排序后按顺序扫描选取边加入最小生成树中,算法的本质思想是( )。
下面程序的运行结果为( )。
1 #include <iostream>
2 #include <algorithm>
3
4 bool check(int n, int a[], int k, int dist) {
5  int cnt = 1;
6  int last = a[0];
7
8  for (int i = 1; i < n; i++) {
9   if (a[i] - last >= dist) {
10    cnt++;
11    last = a[i];
12   }
13  }
14
15  return cnt >= k;
16 }
17
18 int solve(int n, int a[], int k) {
19  std::sort(a, a + n);
20
21  int l = 0;
22  int r = a[n - 1] - a[0];
23
24  while (l < r) {
25   int mid = (l + r + 1) / 2;
26
27   if (check(n, a, k, mid))
28    l = mid;
29   else
30    r = mid - 1;
31  }
32
33  return l;
34 }
35
36 int main() {
37  int a[] = {1, 2, 8, 4, 9};
38  int n = 5;
39  int k = 3;
40
41  std::cout << solve(n, a, k) << std::endl;
42
43  return 0;
44 }下面程序的时间复杂度是( ),假设数组 的值域范围是D。
1 #include <iostream>
2 #include <algorithm>
3
4 bool check(int n, int a[], int k, int dist) {
5  int cnt = 1;
6  int last = a[0];
7
8  for (int i = 1; i < n; i++) {
9   if (a[i] - last >= dist) {
10    cnt++;
11    last = a[i];
12   }
13  }
14
15  return cnt >= k;
16 }
17
18 int solve(int n, int a[], int k) {
19  std::sort(a, a + n);
20
21  int l = 0;
22  int r = a[n - 1] - a[0];
23
24  while (l < r) {
25   int mid = (l + r + 1) / 2;
26
27   if (check(n, a, k, mid))
28    l = mid;
29   else
30    r = mid - 1;
31  }
32
33  return l;
34 }
35
36 int main() {
37  int a[] = {1, 2, 8, 4, 9};
38  int n = 5;
39  int k = 3;
40
41  std::cout << solve(n, a, k) << std::endl;
42
43  return 0;
44 }某二叉树共有10个结点,记为A~J,已知它的先序遍历序列为:A B D H I E C F J G,中序遍历序列为:H D I B E A F J C G,则该二叉树的后序遍历序列是( )。
下面哪一个可能是下图的深度优先遍历序列( )。
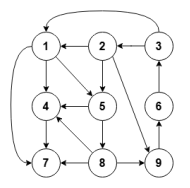
下面这个有向图的强连通分量的个数是( )。
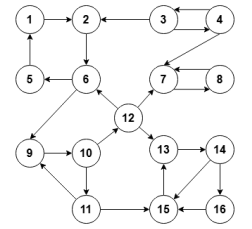
关于泛洪算法(Flood Fill)的说法,正确的是( )。
有 6 个字符,它们出现的次数分别为: {2, 3, 3, 4, 6, 8} ,现在用哈夫曼编码为这些字符编码,最小加权路径长度WPL(每个字符的出现次数×它的编码长度,再把每个字符结果加起来)的值为( )。
关于单链表、双链表和循环链表,下列说法正确的是( )。
下列关于树的遍历的说法中,正确的一项是( )。
C++ 语言中,表达式 4 ^ 2 的结果类型为 int ,值为 6 。
C++ 中引用可以重新绑定。
在 C++ 中,若函数形参为引用类型,则在函数内部对该形参的修改会影响对应的实参。
如果一个最值问题可以用动态规划在多项式时间内求解,那么也一定存在一种贪心策略,可以在多项式时间内求得最优解。
使用归并排序对 个元素进行排序时,无论最好、最坏还是平均情况,时间复杂度均为O(nlogn) 。
在使用 Dijkstra 算法求单源最短路径时,如果发现某条边被选入从源点出发的最短路径生成树中,那么这条边也一定属于该图的某棵最小生成树。
在一个带权无向图中,若所有边的权值都不相同,则该图的最小生成树是唯一的。
若所有字符出现频率相同,则哈夫曼编码一定会得到完全二叉树
使用 math.h 或 cmath 头文件中的函数,表达式: sin(90) 的结果为 1 。
在一个无向连通图中,从任意顶点开始进行深度优先遍历,最终得到的DFS生成树一定包含图中的所有顶点。
试题名称:拆分
时间限制:1.0 s
内存限制:512.0 MB
3.1.1 题目描述
小 A 想将正整数n拆分成若干个正整数之和,并最大化拆分后的正整数之积。小 A 希望你帮他计算出拆分后正整数之积的最大值。由于答案可能很大,你只需要求出答案对109 取模的结果。
形式化地,n的拆分是满足a1+…ak=n的若干个正整数a1,…,ak,其中1≤k≤n。你需要求出n的所有拆分中a1×…×an的最大值对109取模的结果。
3.1.2 输入格式
第一行,一个正整数t,表示数据组数。
对于每组数据:一行,一个整数n,表示给定的正整数。
3.1.3 输出格式
对于每组数据:输出一行,一个整数,表示n拆分后正整数之积的最大值对109取模的结果。
3.1.4 样例
3.1.4.1 输入样例

3.1.4.2 输出样例
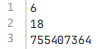
3.1.5 数据范围
对于40%的测试点,保证n≤50。
对于所有测试点,保证1≤t≤104,1≤n≤106。
试题名称:物流网络
时间限制:1.0 s
内存限制:512.0 MB
3.2.1 题目描述
一个物流网络由n个城市和m条双向公路组成。每条公路都有两个属性:
运输费用wi
景观评分bi
当一辆运输车从城市1运送货物到城市n时,需要支付经过道路的运输费用之和。
为了推广旅游线路,物流公司推出了一项优惠政策:在运输路径上,可以免除景观评分最高的那条公路的运输费用。如果有多条公路的景观评分同为最大值,则只免除其中 一条 的费用。
请你计算,从城市1到城市n的最小运输费用。
3.2.2 输入格式
第一行两个整数n,m,分别表示城市数量和公路数量。
接下来m行,每行四个整数u,v,w,b,表示存在一条连接城市u和城市v的双向公路,其中w为运输费用, b为景观评分。
3.2.3 输出格式
输出一个整数,表示从城市1到城市n的最小费用。
如果无法到达,输出 -1 。
3.2.4 样例
3.2.4.1 输入样例

3.2.4.2 输出样例

3.2.5 样例解释
路径1→2→3:费用 10+20,最大美丽值 6 (边2-3)。免除 20,总花费 10。
路径1→3:费用 100,最大美丽值 1 (边1-3)。免除 100,总花费 0。
最小费用为 0。
3.2.6 数据范围
1≤n≤5000,1≤m≤5000,1≤w,b≤109 。
可保存默认模板;新题优先使用已保存模板。
当前快捷键仅展示,暂不支持修改。
Ctrl / ⌘ + ZCtrl / ⌘ + YCtrl / ⌘ + FCtrl / ⌘ + ACtrl / ⌘ + CCtrl / ⌘ + XCtrl / ⌘ + V工具栏排版按钮编辑时自动保存到本机历史
提交记录AI
作答助手确定要清空代码吗?
确定退出考试模式吗?当前作答进度会暂存在本机会话中,下次可继续。
正在处理答卷,请稍候…